自建题库最费时间的环节从来不是做题,而是录题。手上往往已经有一批现成资料:老师发的真题、机构整理的讲义、从各种渠道收集的题目文档。把它们一道道手工敲进系统,成本高到很多人干脆放弃。
这次我们说明一下批量导入的完整能力边界:支持哪些格式、两条导入路径分别适合什么场景、任务在什么时候算完成,以及失败时会发生什么。
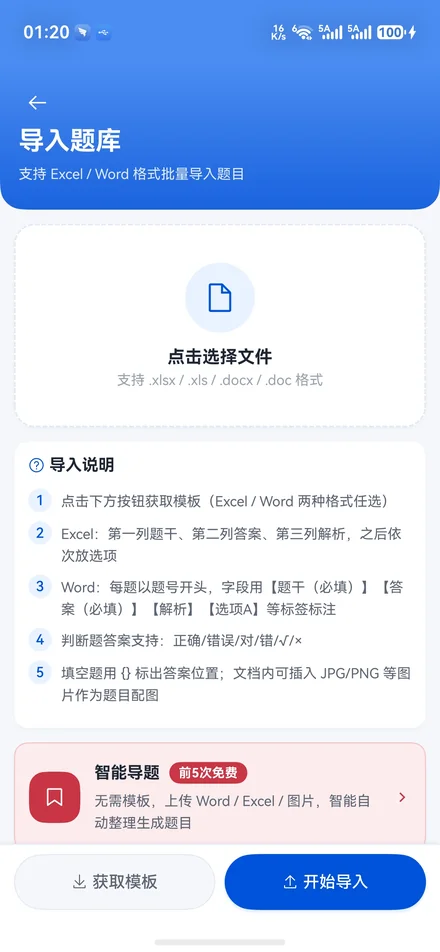
核心结论:Excel(.xlsx)、Word(.doc/.docx)与 PDF 均支持导入。官方 Excel 模板走确定性解析,题量不设上限;非模板文档走智能识别,自动识别题型、题干、选项、答案与解析。任务在后台异步处理,可以离开页面,失败自动退还次数。
两条路径,按文档情况选择
导入入口只有两个,选择依据很简单——你的文档是否已经按官方模板整理过。
- 官方 Excel 模板:字段是确定的,每一列对应题干、选项或答案,因此走确定性解析。这条路径结果可预期,适合批量录入,题量不设上限。
- 非模板文档:Word 讲义、PDF 真题等格式自由,走智能识别。系统会自动识别题型、题干、选项、答案与解析,再整理成规范题目入库。
如果你手上是大量纸质资料的电子版,用智能识别更省事;如果你本来就有一份结构规整的表格,用官方模板会更快、更准。
智能识别能处理什么
非模板文档的难点在于版式不统一:题号写法不同、选项用字母或圆圈、答案与解析可能单独放在文末。智能识别做的就是把这些差异抹平——
- 自动判断题型,选择题与判断题全兼容
- 把题干、各个选项拆成独立字段,而不是一坨文本
- 匹配答案与解析,尽量让每道题都带上解析
- 整理成规范题目后入库,后续练习与组卷逻辑完全一致
识别结果入库前你可以核对和修改,不必担心个别题目解析错位就只能推倒重来。
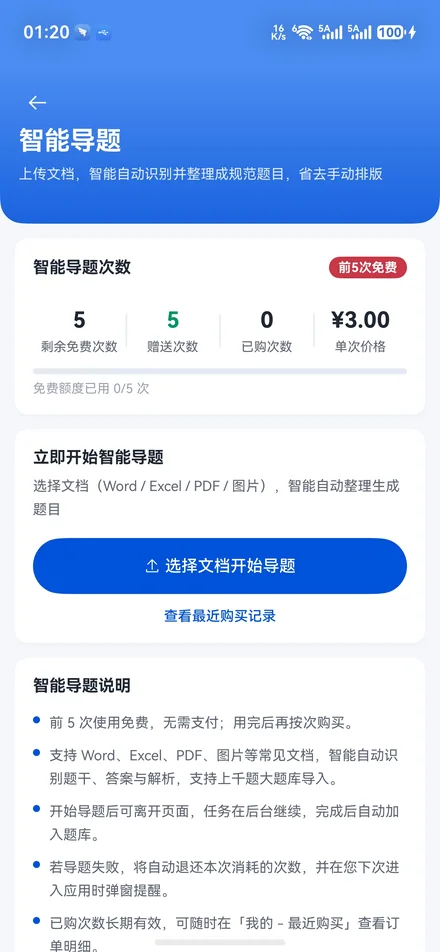
后台处理:可以离开页面,失败自动退次数
上千题的文档解析需要时间,因此任务提交后在服务端后台继续执行,你不需要守着这个页面:
- 关闭页面或切到其他应用都不会中断任务
- 解析完成后题库自动建立,下次进入时会收到提醒
- 处理时间较长的任务会显示解析进度,避免「不知道跑到哪了」
- 如果解析失败,系统会自动退还本次消耗的导题次数
关于次数,说明一下当前的规则:微信登录后导题前 5 次免费,次数用完后按次购买,不订阅、不自动续费。失败的导入不会占用你的额度,这一点是系统自动处理的,不需要联系客服申请。
最后给一个实操建议:第一次导入一份新格式的文档时,先切出二十来道题试一次,确认解析质量符合预期,再整份提交。这样最省时间,也最不容易返工。